公開検証記録 · 2026年8月20日確認

数式 OCR の検証記録:数学 PDF から Word へ

この記録では、2 回のデスクトップセッションで保存された Offline OCR のスクリーンショット 3 枚を検証します。資料から裏付けられる内容、確認できる出力上の問題点、そしてこれらだけでは認識精度をパーセンテージで示せない理由を説明します。

Offline OCR の開発者 Lingyun Zheng が作成しました。

開示事項:これは製品提供元が作成した検証記録であり、独立した研究機関による評価ではありません。記載する主張は、2026年8月20日に確認した保存資料と製品の実装に意図的に限定しています。

要約

保存された資料から確認できるのは、限定的なワークフローの実行実績です。Offline OCR はあるセッションで 1 ページの PDF を処理し、別の 5 月 28 日のセッションでは文章と数式が混在する内容を表示し、PDF のエクスポートを開始し、Microsoft Word で開ける DOCX ファイルを生成しました。ただし、元の入力ページ、正解となる転記内容、正確なアプリのバージョン、修正履歴が一式で保存されていないため、これらの資料から認識精度を立証することはできません。

資料から裏付けられる内容

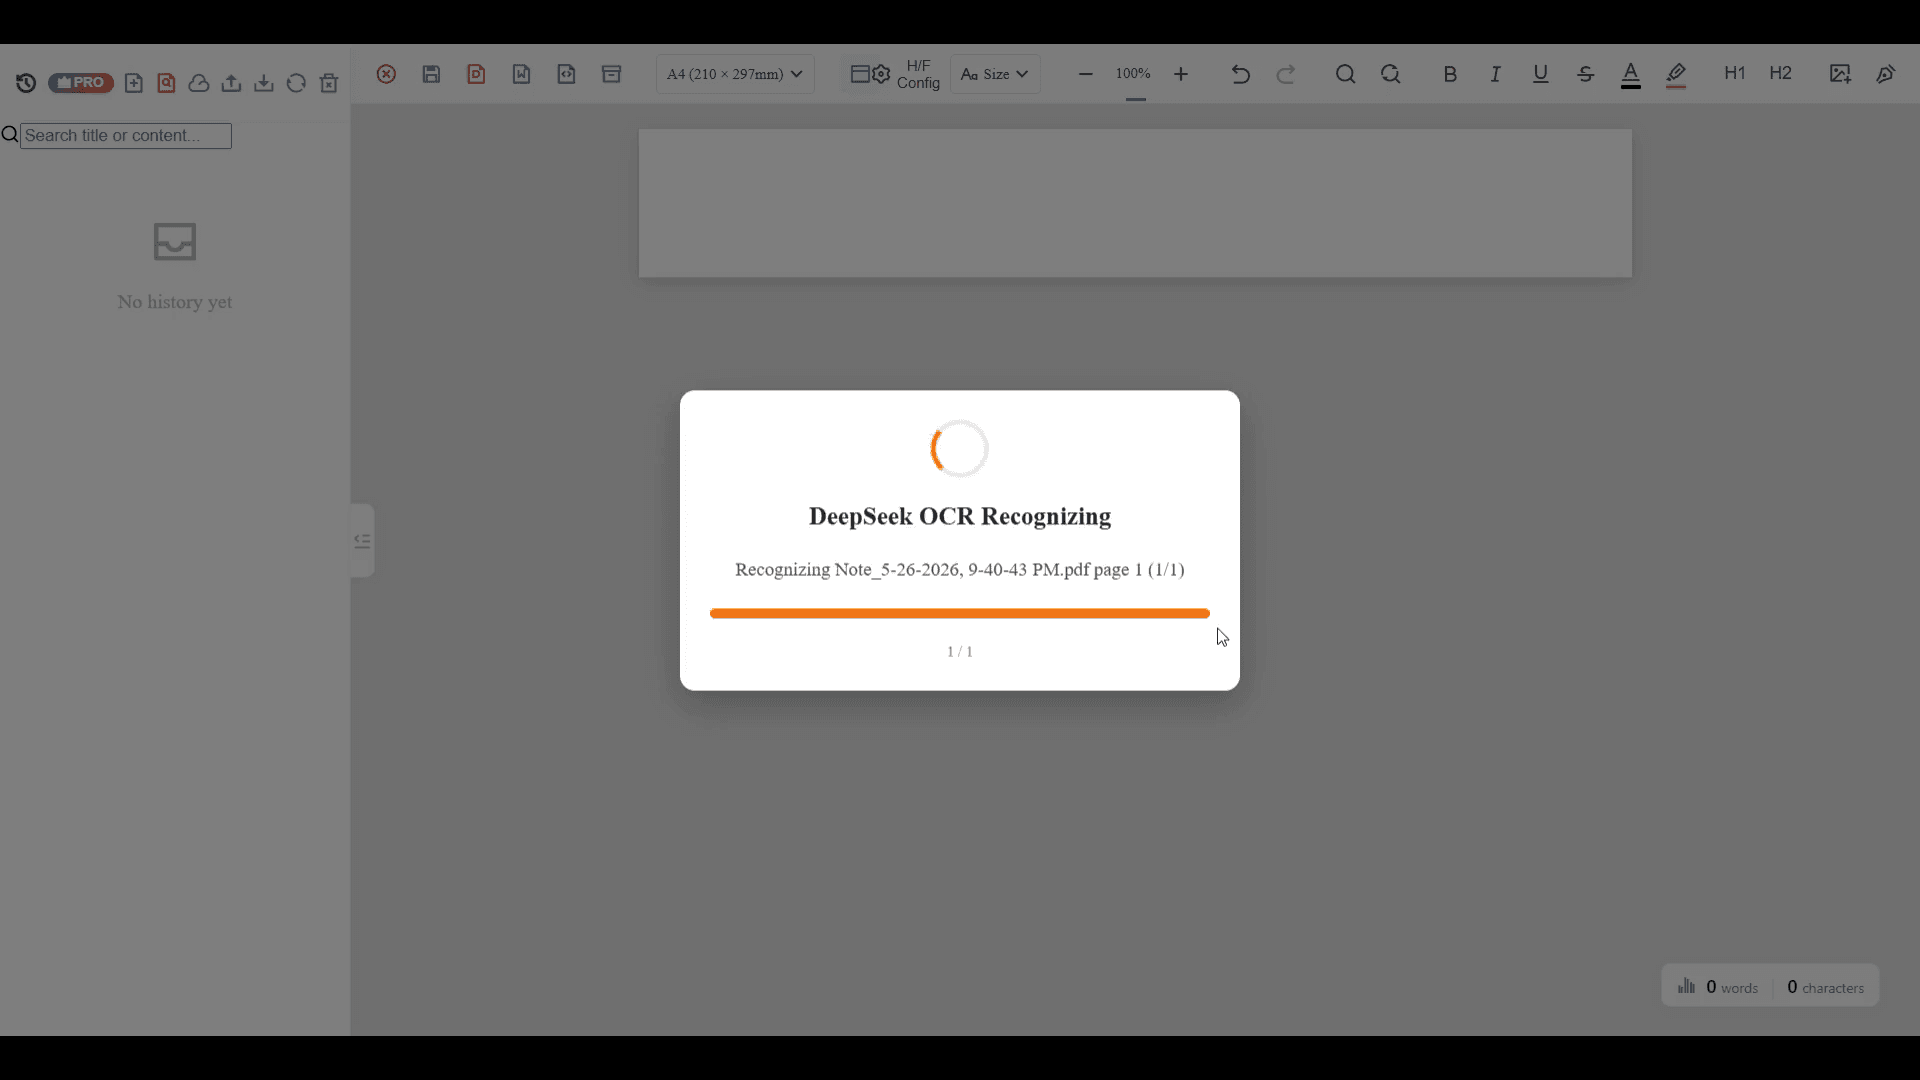
  • 5 月 26 日のデスクトップ画面には、1 ページの PDF の 1 ページ目に対して「DeepSeek OCR Recognizing」と表示されていることが確認できます。調査した製品実装では、このエンジンに「Local LLM」というラベルが付けられています。
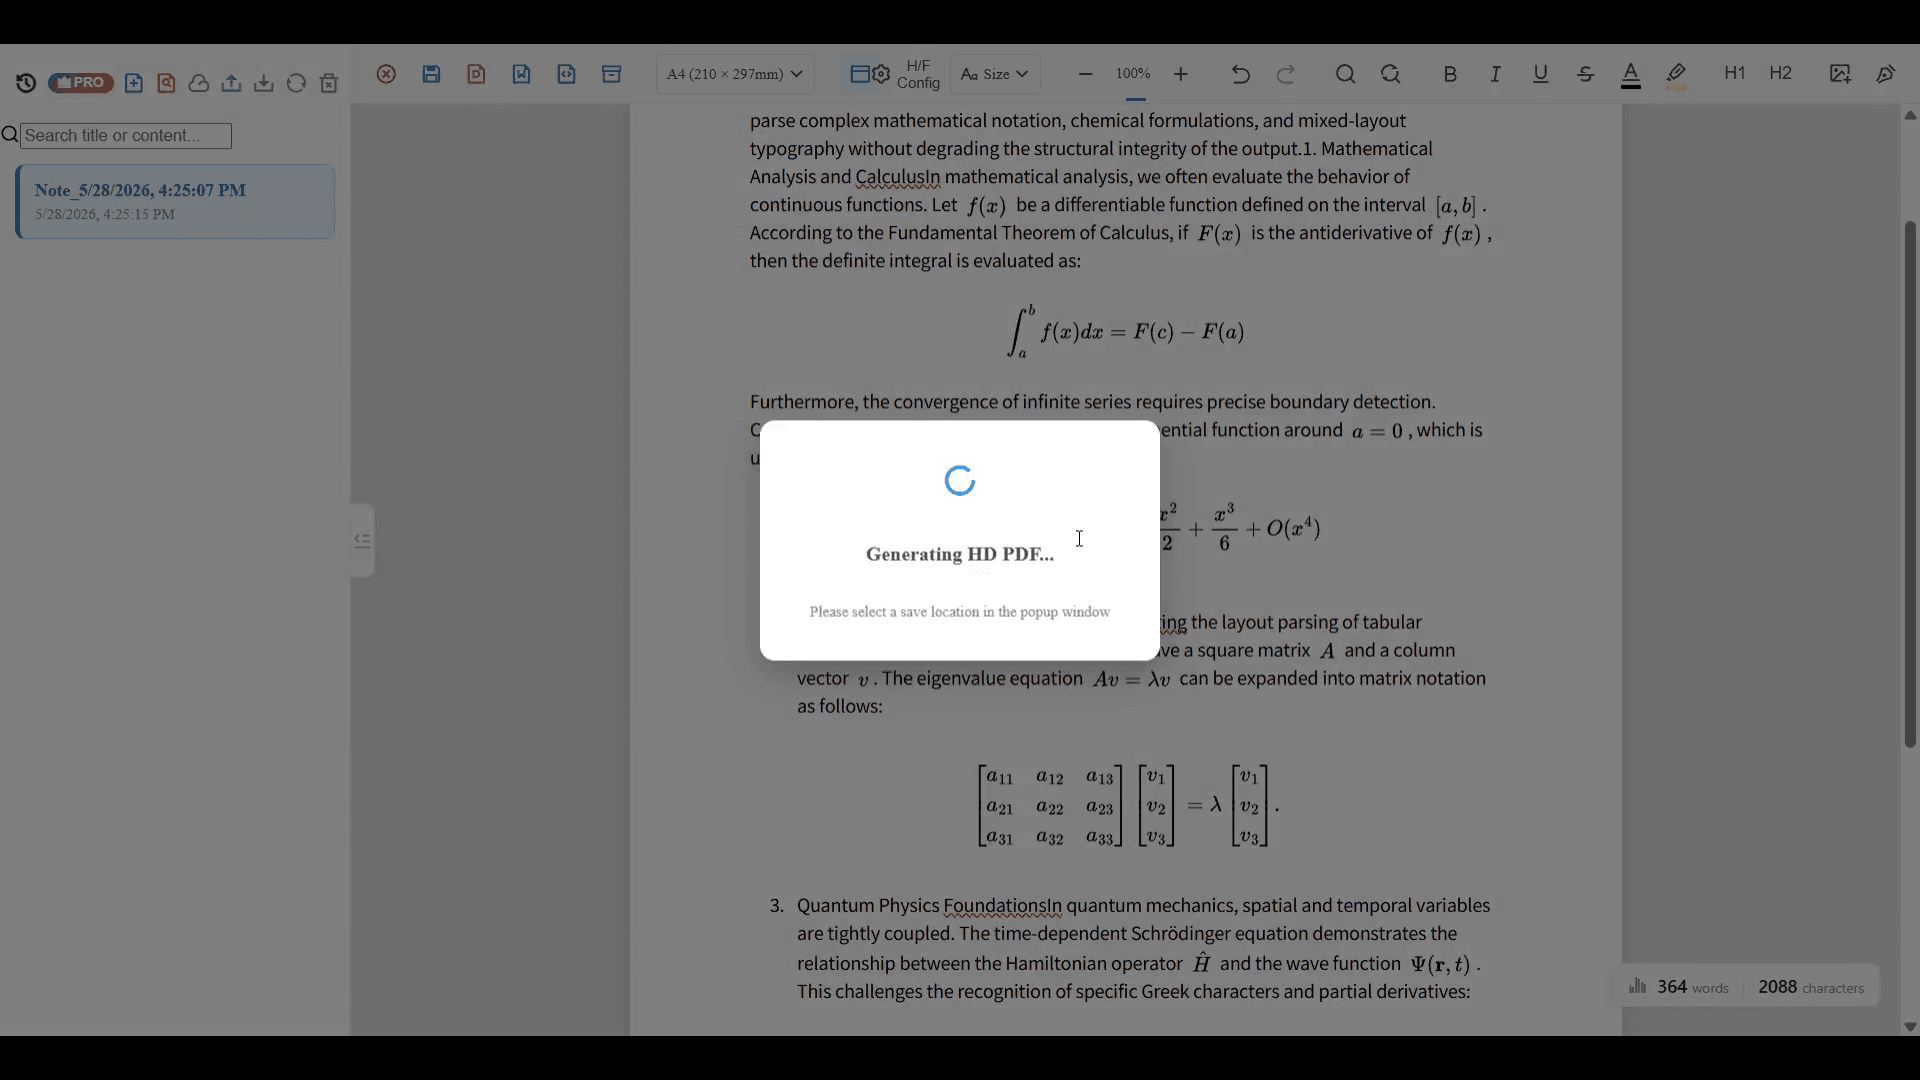
  • 5 月 28 日のデスクトップ画面には、Offline OCR エディター内で文章、積分、テイラー級数、行列が表示され、高画質 PDF の生成が開始された様子が示されています。
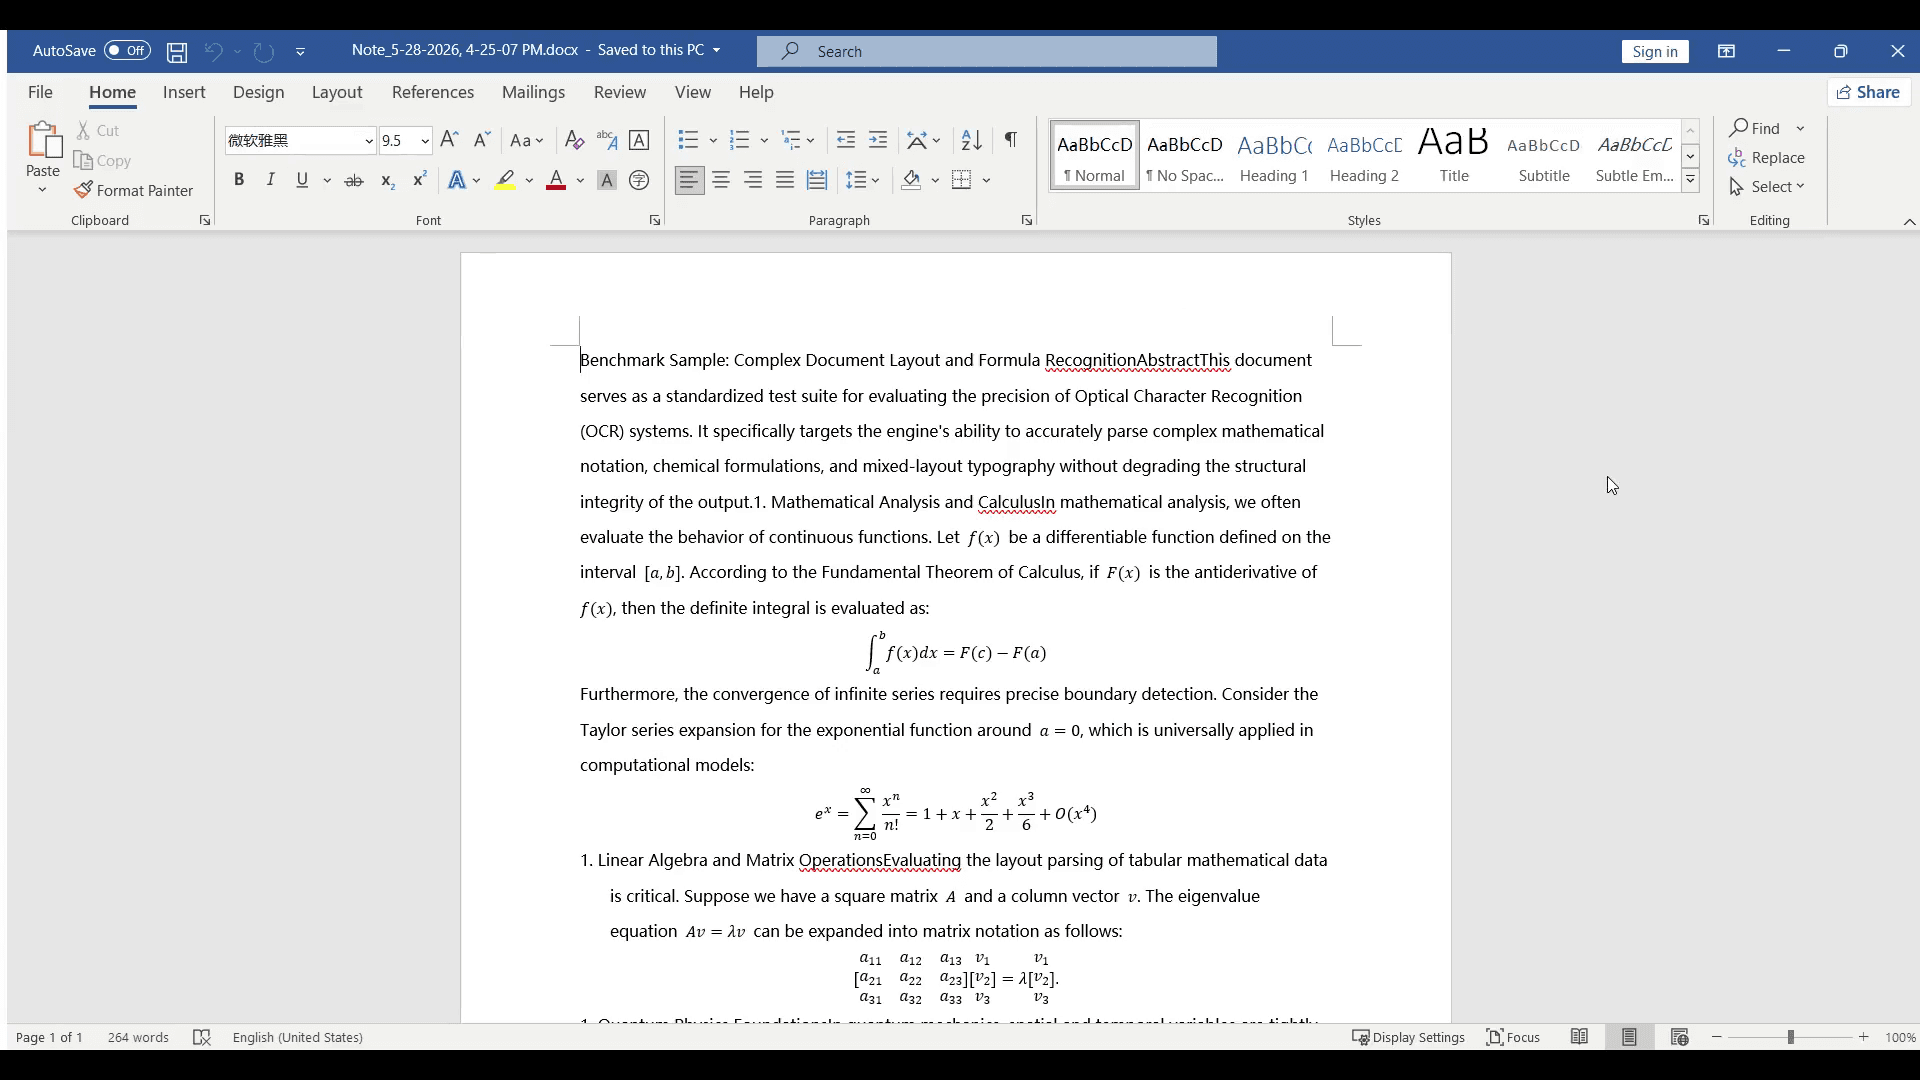
  • 5 月 28 日の DOCX ファイルは Microsoft Word で開かれており、ページ上に段落と数式表記が表示されています。
資料からは確認できないこと

  • 元の入力とレビュー済みの正解出力がなければ、記号単位、数式単位、ページ単位の認識精度をパーセンテージで算出することはできません。
  • 5 月 28 日の処理モードと Offline OCR の正確なバージョンは記録されていません。
  • 静止した Word のスクリーンショットだけでは、すべての数式オブジェクトやレイアウト要素が編集可能であることは証明できません。

証拠資料一覧

以下の日付と観察内容は、保存されたスクリーンショットで確認できる情報に基づいています。5 月 26 日と 5 月 28 日の画像は別々のセッションとして扱い、単一のエンドツーエンドテストとして結合していません。

検証した証拠資料
ウェブサイトに保存された製品の元のスクリーンショット 3 枚
確認できるセッションの日付
2026年5月26日と2026年5月28日
確認できるプラットフォーム
Windows デスクトップ
5 月 26 日に確認できる入力
1 ページの PDF。スクリーンショットには全 1 ページ中の 1 ページ目が表示されています
5 月 26 日に確認できる認識エンジン
DeepSeek OCR。調査した製品実装ではローカルモデルとして識別されています
5 月 28 日に確認できる内容
積分、級数、行列、ギリシャ文字が混在する英語の文章
5 月 28 日に確認できるエクスポート
高画質 PDF の生成と、Microsoft Word で開かれた .docx ファイル
アプリのバージョン
スクリーンショットに保存されていない情報
元の入力資料と期待される出力
この公開記録には保存されていません
認識精度スコア
未報告。妥当な算出に必要な証拠が不足しています

各スクリーンショットの内容

2026 年 5 月 26 日の Offline OCR デスクトップ画面。DeepSeek OCR が 1 ページの PDF の 1 ページ目を認識中

資料 1 — 認識処理中

ダイアログには「DeepSeek OCR Recognizing」と表示され、1 ページの PDF が示されています。調査した製品実装では、このエンジンは「Local LLM」と表記されています。この資料からは入力ページ、最終結果、撮影時のデバイスのネットワーク接続状態は確認できません。

5 月 28 日の積分、テイラー級数、行列表記を含む数学文書から、高画質 PDF を生成している Offline OCR エディター

資料 2 — エディターと PDF エクスポート

5 月 28 日のエディター画面には、文章と構造化された数式が混在しています。エクスポートダイアログには「Generating HD PDF」と表示されています。文書内には単語が結合してしまった箇所が残っているため、これはワークフローの実行を示す証拠であり、完全な認識精度を示すものではありません。

Microsoft Word で開かれた 5 月 28 日の Offline OCR DOCX ファイル。文章、積分、テイラー級数、行列表記を含む

資料 3 — Word で開いた DOCX

Microsoft Word では、エクスポートされた .docx が開かれ、ページ上に数式表記が表示されています。スクリーンショットから表示結果は確認できますが、個々の数式オブジェクトが内部的に編集可能かどうかまでは確認できません。

確認できる制限事項

この記録では認識エラーを隠さずに示しています

5 月 28 日のスクリーンショットには、「RecognitionAbstractThis」「CalculusIn」「OperationsEvaluating」「FoundationsIn」のように単語の境界が結合している箇所が明確に見られます。一部の見出しや番号付きセクションも隣接する文章とつながっています。これらは編集上の重大な問題であり、信頼できる事例では隠すべきではありません。

テキストの区切りを確認する必要があります

複数の単語や見出しが結合しています。文書を再利用する前に、スペースや段落の区切りを修正する必要があると考えてください。

数式の表示と認識精度は別の問題です

スクリーンショットには積分、分数、行列、ギリシャ文字が表示されていますが、元のページがないため、記号ごとの正確性は確認できません。

エクスポートの証拠だけでは編集可能性を保証できません

Word で .docx ファイルを開けることは、使用可能な文書が生成されたことを示します。ただし、それだけでは表示されているすべての数式が Word ネイティブの編集可能な数式オブジェクトとして保存されたことを証明できません。

再現可能なテスト

再現可能な OCR 記録に含めるべき情報

精度に関する主張には、同じ入力と同じ未編集の出力結果を用いた再現可能な実行が必要です。

  1. 1元の入力ページまたはそのハッシュ値を公開し、ライセンスまたは所有権を記録します。
  2. 2Offline OCR のバージョン、オペレーティングシステム、デバイス、処理モードを記録します。
  3. 3手動修正を行う前に、生の OCR 結果を保存します。
  4. 4正解となる転記内容を公開し、記号、構造、レイアウトの採点方法を定義します。
  5. 5すべての修正を個別に列挙し、レビュー日を記載します。
  6. 6成功例と失敗例を同じ公開テストセットに含めます。

この検証記録についてのよくある質問

この記録は Offline OCR の認識精度を証明していますか?

いいえ。実際の製品ワークフローの一部は検証していますが、公開資料には精度の算出に必要な元データと、検証済みの期待出力が含まれていません。

これらのスクリーンショットではローカル OCR が使用されていますか?

5月26日のスクリーンショットには DeepSeek OCR が明示されており、製品の実装を調査した結果、このエンジンはローカルモデルであることが確認されています。ただし、スクリーンショットだけではデバイスのネットワーク接続状態は証明できません。別途行われた5月28日の書き出しセッションでは処理モードを確認できないため、その点については断定していません。

Word のスクリーンショットで、すべての数式が編集可能だと証明できますか?

いいえ。DOCX ファイルが Microsoft Word で開かれ、数式表記が表示されたことを示すものです。個々のオブジェクトが編集可能かどうかの確認には実際のファイルの調査が必要ですが、この公開記録には含まれていません。

明らかな誤りを含む例を公開するのはなぜですか?

確認できる制約を公開することで、ユーザーは修正に必要な作業量を判断しやすくなり、ワークフローのスクリーンショットを独立評価されたベンチマーク結果と誤認することも防げます。

OCR に関する主張を信頼する前に、ご自身の文書でテストしてください

代表的なページを使用し、未修正の認識結果を保存して、文書を書き出したり公開したりする前にすべての数式を確認してください。

検証記録の確認日:2026年8月20日。