封存資料能夠證明的內容
- 5 月 26 日的一張桌面端截圖清楚顯示,單頁 PDF 的第 1 頁正在進行「DeepSeek OCR Recognizing」;所檢查的產品實作將該引擎標示為「Local LLM」。
- 5 月 28 日的一張桌面端截圖顯示,Offline OCR 編輯器中呈現了混合文字、積分、泰勒級數和矩陣的內容,同時開始產生高畫質 PDF。
- 5 月 28 日產生的 DOCX 檔案已在 Microsoft Word 中開啟,頁面上可見呈現後的段落和數學記號。
公開證據記錄 · 審查於 2026 年 8 月 20 日
本記錄分析了來自兩次桌面端使用工作階段的三張 Offline OCR 封存截圖,說明這些資料能支持哪些結論,公開呈現可見的輸出問題,並解釋為何不能據此得出準確率百分比。
由 Offline OCR 開發者 Lingyun Zheng 編製。
聲明:本記錄是由產品開發方編製的證據記錄,並非獨立實驗室評測。所有結論均嚴格限定於 2026 年 8 月 20 日所檢查的封存資料和產品實作。
簡要結論
封存資料僅支持有限的工作流程結論:Offline OCR 在一次工作階段中處理了一份單頁 PDF;另一次於 5 月 28 日進行的工作階段中,應用程式呈現了混合文字與公式的內容、啟動了 PDF 匯出,並產生了一份可在 Microsoft Word 中開啟的 DOCX 檔案。但這些資料無法證明辨識準確率,因為原始來源頁面、預期轉錄文字、確切應用程式版本和修正記錄並未完整地一併保存。
以下日期和觀察結果均來自封存截圖中可見的資訊。5 月 26 日和 5 月 28 日的截圖被視為兩次獨立工作階段,不會合併認定為一次完整的端對端測試。
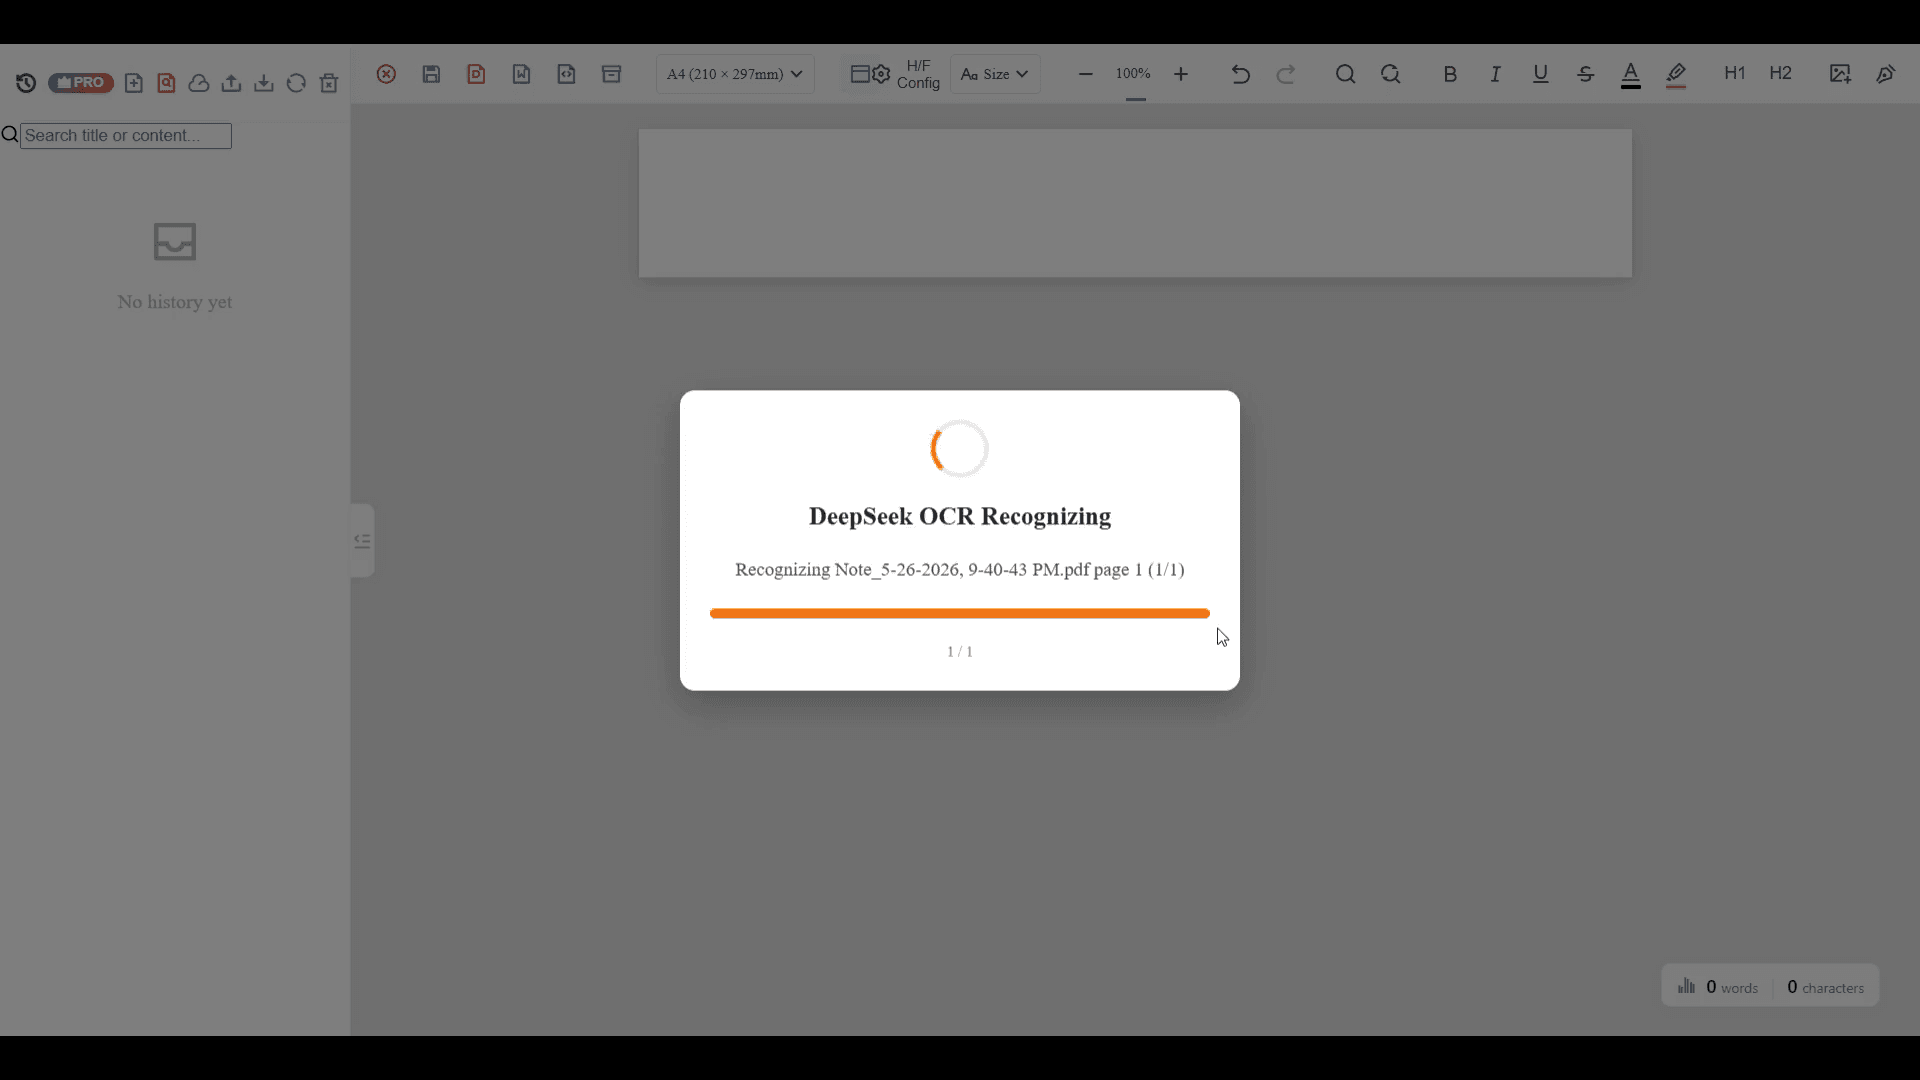
對話方塊顯示「DeepSeek OCR Recognizing」,並指出正在處理一份單頁 PDF。所檢查的產品實作將該引擎標示為「Local LLM」。這份資料未呈現輸入頁面、最終結果,也未顯示截圖時裝置的網路連線狀態。
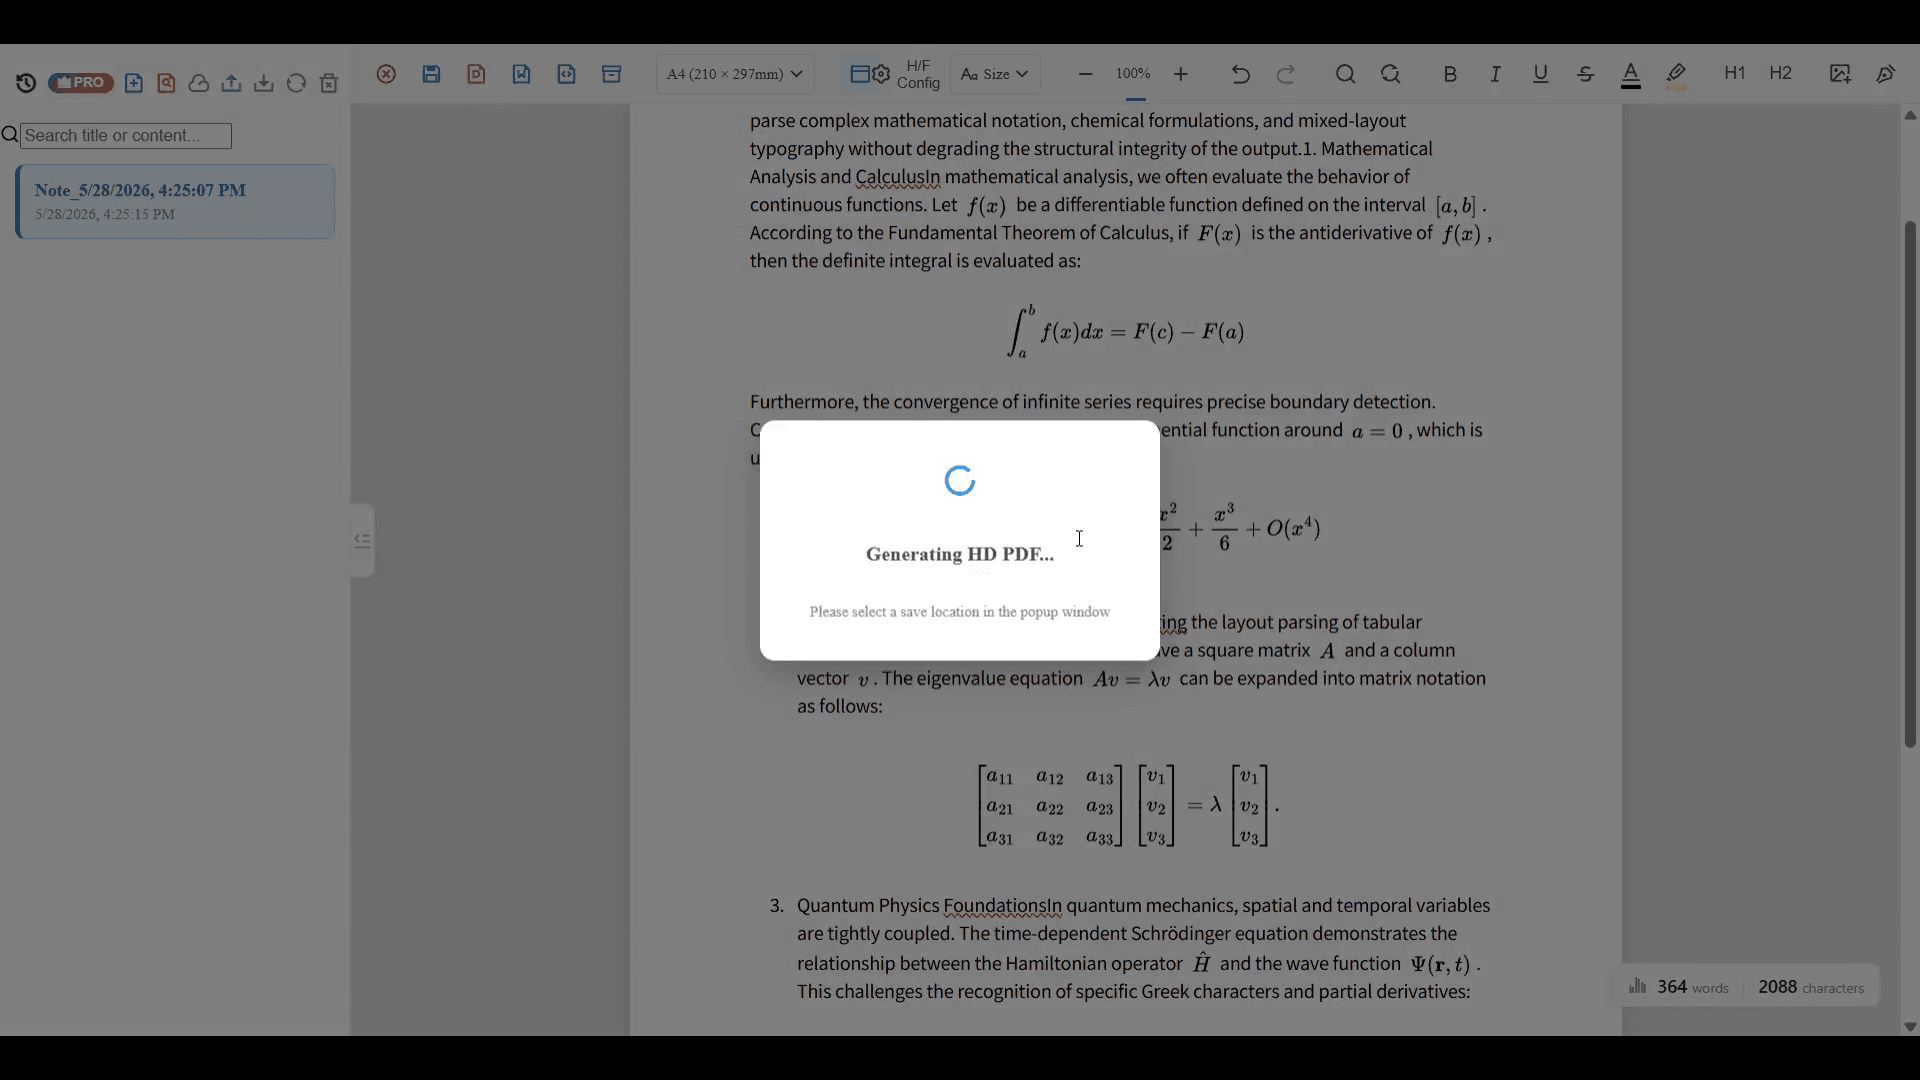
5 月 28 日的編輯器畫面包含混合文字和結構化公式。匯出對話方塊顯示「Generating HD PDF」。文件中仍可看到詞語黏連的問題,因此這只能作為工作流程已執行的證據,而非辨識完全準確的證明。
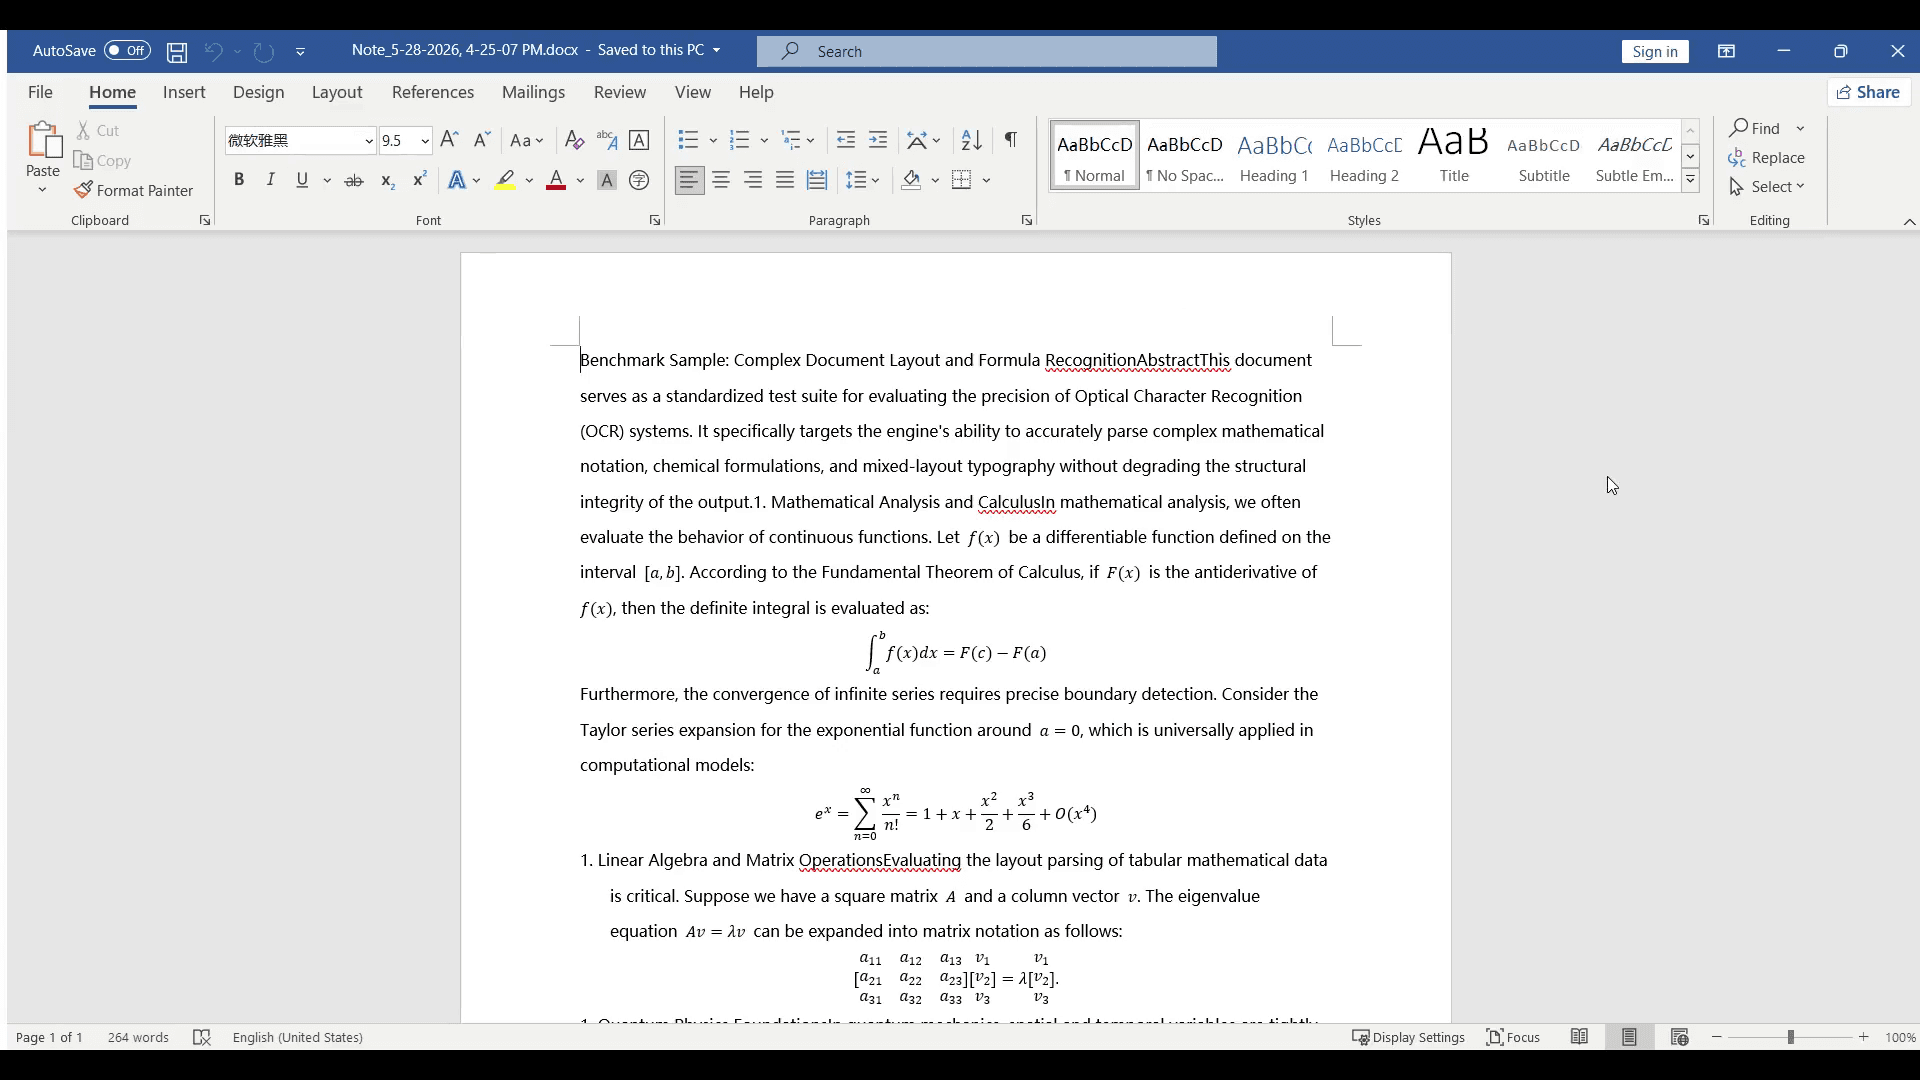
Microsoft Word 在頁面上顯示了匯出的 .docx 檔案及其中呈現的數學記號。截圖可以確認可見的結果,但無法證明每個公式物件在內部是否可編輯。
可見的限制
5 月 28 日的截圖中明顯存在「RecognitionAbstractThis」、「CalculusIn」、「OperationsEvaluating」和「FoundationsIn」等詞語黏連現象。部分標題和編號章節也與相鄰文字連在一起。這些問題會對編輯造成實質影響,不應在可信的範例中被隱藏。
多個單字和標題被錯誤地連接在一起。使用者在重複使用文件前,應準備好還原空格和段落邊界。
截圖顯示了積分、分數、矩陣和希臘字母,但由於缺少原始來源頁面,無法逐一核對每個符號的正確性。
能在 Word 中開啟 .docx 檔案,證明已產生一份可用的文件。但僅憑這一點,無法證明每個可見公式都以 Word 原生可編輯公式物件的形式儲存。
可重現測試
準確率聲明必須以使用相同輸入及相同未經編輯的輸出結果進行的可重複測試為依據。
不能。它驗證了實際產品工作流程的部分環節,但公開資料不包含計算準確率所必需的原始來源和經過審核的預期輸出。
5 月 26 日的截圖明確顯示使用了 DeepSeek OCR,而對產品實作程式碼的檢查表明,該引擎是本機模型。但僅憑截圖無法證明裝置當時的網路連線狀態。另一次 5 月 28 日匯出工作階段所使用的處理模式無法從資料中看出,因此不對此作出斷言。
不能。它只能證明某個 DOCX 檔案已在 Microsoft Word 中開啟,並顯示了數學符號。要確認個別物件是否可編輯,必須檢查實際檔案,而這不屬於本次公開紀錄的內容。
公開可見的限制有助於使用者判斷需要投入多少修正工作,也能避免將工作流程截圖誤認為經過獨立評分的基準測試結果。
選取具有代表性的頁面,保留原始辨識結果,並在匯出或發布文件前檢查每一個公式。
驗證紀錄審查日期:2026 年 8 月 20 日。